AI crawler 策略以前只是 robots.txt 的附带项。现在它已经是 Agent SEO 的核心决策。
原因很简单:抓取不再只意味着传统搜索索引。一个 crawler 可能用于搜索索引、在助手里替用户抓取页面、为实时答案做 grounding、训练模型、渲染预览,或者替 agent 检查一个工作流。
这些用途不同,不能放进同一个篮子。
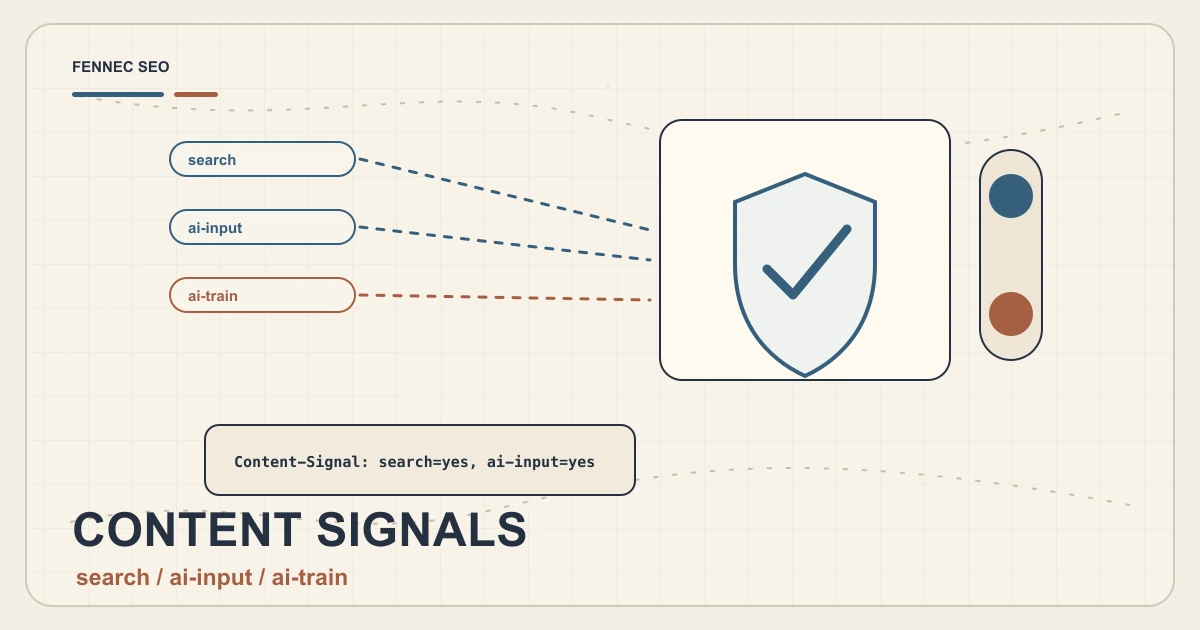
Content Signals 给发布者提供了更精确的表达方式。
这篇是 Agent SEO 审计集群 里的政策 spoke。针对具体 user agent 的 robots 示例,请看 GPTBot、OAI-SearchBot 与 Googlebot 指南。
如果要把策略检查和发现、协议检查放在同一个产品清单里看,可以打开 Agent SEO 审计页。
访问规则 vs 使用偏好
先分清两个问题。
| 问题 | 最适合表达的位置 |
|---|---|
| 这个合规 crawler 是否应该抓这个 URL? | robots.txt 的 user-agent 和路径规则 |
| 已抓取内容可以如何使用? | Content-Signal 指令 |
| 这个 bot 真的是它声称的身份吗? | 验证、日志、Web Bot Auth、CDN bot controls |
| 是否要技术性执行? | WAF、AI Crawl Control、rate limit、认证 |
这个区别很重要,因为 robots.txt 是自愿遵守的。它向守规矩的 bot 表达偏好,但并不会物理阻止请求。
Agent SEO 需要两边都处理:让想要的 agent 看到内容,同时控制不接受的使用方式。
Content Signals 表达什么
Cloudflare 的 Content Signals 定义了三类用途:
search:建立搜索索引并提供带链接搜索结果ai-input:在查询时把内容作为 AI 模型输入,例如 grounding 或 RAGai-train:训练或微调模型
search=yes 不等于自动允许 AI-generated summaries。AI 答案、grounding 或 RAG 更应该看 ai-input。
一个基础策略可以这样写:
User-agent: *
Content-Signal: search=yes, ai-input=yes, ai-train=no
Allow: /

Sitemap: https://example.com/sitemap.xml
含义是:欢迎搜索;可以作为 AI 答案输入;不允许模型训练。
这是不是适合你,要看业务目标。
先做策略矩阵
不要一开始就改 robots.txt。先做矩阵。
| 内容类型 | Search | AI input | AI training | 说明 |
|---|---|---|---|---|
| 公开博客 | yes | yes | decide | 如果需要引用和 attribution,有利于 GEO |
| 产品页 | yes | yes | decide | 声明必须准确并及时更新 |
| 文档 | yes | yes | decide | 通常对 agent 和支持流程有价值 |
| 价格页 | yes | yes | no 或 decide | 必须保持最新 |
| 用户账号页 | no | no | no | 本来就应该在认证后 |
| Checkout | no | no | no | Agent commerce 需要明确设计 |
| Staging | no | no | no | 阻止并加认证 |
这样 crawler 决策不会只靠情绪,也方便法务、产品、SEO 和工程讨论同一套策略。
不要挡住自己的可见性
最贵的错误是误伤可见性。
常见问题:
- 想屏蔽私有 app 路径,却屏蔽了
/blog/ - 不理解哪些 bot 支持搜索发现,就屏蔽所有 AI 相关 bot
- 屏蔽渲染所需 CSS 或 JavaScript
- 忘记
/zh/等多语言路径 - 把 staging robots.txt 发布到生产
- 给同一个 user agent 写冲突规则
- 以为
Content-Signal能阻止恶意流量
如果目标包括 AI search visibility、GEO 或 agent-assisted discovery,屏蔽所有 AI crawler 可能反而伤害你。
上线前用 robots.txt validation 和 bot simulation 检查。
更稳的 robots.txt 模式
对很多公开内容站,一个实用起点是:
User-agent: *
Content-Signal: search=yes, ai-input=yes, ai-train=no
Allow: /

Disallow: /app/
Disallow: /admin/
Disallow: /checkout/

Sitemap: https://example.com/sitemap.xml
只有在有明确原因时,再加 crawler-specific 规则。
例如允许搜索 crawler,但屏蔽某个训练 crawler:
User-agent: GPTBot
Disallow: /

User-agent: *
Content-Signal: search=yes, ai-input=yes, ai-train=no
Allow: /
具体 user agent 和策略应来自最新 crawler 文档以及你的业务风险承受能力。
例如 OpenAI 把训练、AI 搜索和用户触发浏览的 crawler 分开说明。如果你的策略依赖这个差异,应把 Content Signals 层和 GPTBot、OAI-SearchBot、Googlebot robots.txt 指南 里的 crawler-specific 规则配套使用。
Web Bot Auth 放在哪里
User-agent 字符串可以伪造,IP 范围也会变化。Cloudflare 的 Web Bot Auth 以及相关 HTTP message signature 提案,试图解决另一个问题:bot 如何用密码学方式证明身份。
对大多数 SEO 团队,眼下不一定要马上实现所有新标准,但必须理解身份问题:
- 声称的 user agent 不等于证明
- reverse DNS 有帮助,但运维上脆弱
- 签名请求可以提供更强身份信号
- 访问策略的效果取决于验证与执行
随着 agent 流量增长,bot identity 会成为 SEO operations 的一部分,而不只是安全团队的问题。
它和 GEO 的关系
GEO 不只是“被引用”,还要在业务能接受的条件下被引用。
发布者可能希望:
- 有搜索摘要和链接
- 有 AI answer citation
- 允许用户触发的 assistant access
- 不允许模型训练
- 有清晰 attribution
- 爬取频率合理
- 不访问私有或付费内容
Content Signals 不能保证全部实现,但它提供了清晰、机器可读的政策起点。
还应配合:
- Server log monitoring
- Crawler verification
- CDN bot controls
- Rate limit
- Caching
- 清晰内容授权
- 定期策略复查
审计流程
发布新的 AI bot 策略前,跑这套清单。
- 抓取
robots.txt,确认返回 200。 - 确认 sitemap 指令存在。
- 用 robots checker 验证语法。
- 检查
Content-Signal是否匹配策略矩阵。 - 用 crawler user agent 测试重要公开 URL。
- 确认私有 app 路径被阻止或需要认证。
- 发布后复查服务器日志。
- 用 IsItAgentReady 重新扫描,并和 Agent SEO audit framework 对照。
- 产品或内容有重大变化后复查策略。
这不是一次性文件,而是持续维护的访问政策。
总结
Agent SEO 同时需要可见性和控制权。
用 robots.txt 表达合规 bot 的抓取偏好,用 Content Signals 表达内容用途偏好,用日志和 bot controls 执行真正重要的限制。然后衡量 agent 是否仍能发现并读取支持 SEO、AI search visibility 和 GEO 的公开内容。
好策略不是“全放开”或“全屏蔽”,而是对友好 bot 足够清晰,对业务风险足够克制,对运营团队足够可测试。
来源
- Cloudflare Docs: managed robots.txt and Content Signals
- Cloudflare: Introducing the Agent Readiness score
- Cloudflare: Web Bot Auth
- OpenAI: Crawlers and user agents
- Google Search Central: robots.txt introduction
问答
Content Signals 和 robots.txt 的 Disallow 是一回事吗?
不是。robots.txt 表达合规 crawler 应该或不应该抓取哪些路径;Content Signals 表达已抓取内容可以如何使用,例如 search、AI input 或 AI training。
Content Signals 能技术性阻止坏 bot 吗?
不能。和 robots.txt 一样,Content Signals 是偏好信号。真正执行需要日志、CDN 控制、bot management、rate limit 或认证等访问控制。
Content-Signal 里的 search、ai-input、ai-train 有什么区别?
search 覆盖搜索索引和带链接结果,ai-input 覆盖请求时用于 AI 答案或 grounding,ai-train 覆盖模型训练或微调。
应该屏蔽 GPTBot 但允许 OAI-SearchBot 吗?
如果你想要 AI 搜索发现但不想允许训练用途,这可能是合理策略,但最终规则应基于最新 crawler 文档和业务政策。